Agentes de IA
ThinkingBox: mejorar un agente también puede hacerle perder soluciones
Microsoft y Hugging Face entrenan agentes comprobando qué cambian en una base de datos. Mejoran la constancia, aunque pierden cobertura en la prueba.
Acertar más y abarcar menos puede ocurrir a la vez
ThinkingBox Training consigue que un agente repita más veces una tarea correctamente. En la misma prueba quedan sin resolver algunas tareas que antes superaba al menos una vez. Ese resultado, presentado por Microsoft y Hugging Face el 22 de octubre, muestra por qué una media de aciertos no explica toda la mejora.
La propuesta conecta el entrenamiento con algo que puedes comprobar: los registros que quedan después del trabajo. Si el agente dice que ha cambiado un pedido, el sistema revisa qué ha cambiado realmente.
La recompensa sale del resultado del trabajo
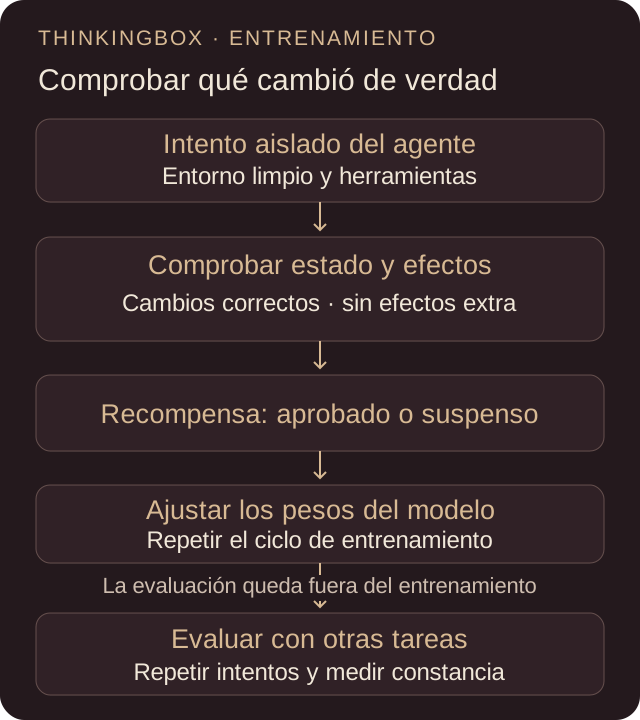
Cada intento arranca con un entorno limpio, herramientas MCP y un usuario simulado que conversa con el agente. Al terminar, unas comprobaciones inspeccionan el estado final y los efectos de sus acciones. Devuelven un aprobado o un suspenso que se utiliza para ajustar el modelo mediante aprendizaje por refuerzo.
La mayoría de esas comprobaciones son deterministas: código que contrasta datos. Una minoría incorpora un modelo juez para requisitos concretos que la base de datos no refleja bien. El usuario simulado y el juez cumplen funciones distintas.
Esto modifica los pesos del modelo. Se diferencia de mejorar sus instrucciones o herramientas, como hace Harness². Son dos maneras de intervenir en un agente y necesitan evaluarse por separado.
Cambiar una dirección sin tocar el pedido equivocado
Imagina una tienda donde alguien pide cambiar la dirección de su pedido pendiente. Tiene otro pedido que ya está enviado. El agente encuentra al cliente, modifica una dirección y responde que todo está listo.
Una comprobación útil revisaría que el pedido pendiente tenga la dirección nueva, que el enviado conserve la anterior y que no se haya creado otro pedido. Así se detectaría tanto una acción que falta como un cambio que sobra. Es un ejemplo hipotético, no una prueba del proyecto.
La precisión del comprobador importa tanto como la del agente. Si solo mira que exista una dirección nueva, podría aprobar una modificación hecha en el pedido incorrecto. Y si la tarea exige pedir confirmación antes del cambio, comprobar únicamente el registro final no demuestra que se haya respetado ese paso. Haría falta conservar y revisar esa evidencia también.
La cifra interesante está al lado de la media
Los autores entrenaron Qwen3.8-27B durante 50 pasos y evaluaron 507 tareas sintéticas, con 20 intentos por tarea. El éxito medio pasó del 51,70 % al 60,78 %. Al mirar las tareas completas aparece el matiz.
| Resultado observado | Antes | Después |
|---|---|---|
| Tareas correctas en los 20 intentos | 38 | 107 |
| Tareas correctas al menos una vez | 453 | 446 |
Qué puedes aprovechar sin entrenar un modelo
Hay más tareas que salen bien en todos los intentos registrados, pero menos que llegan a resolverse alguna vez. Son resultados de este experimento, no una comparación independiente ni una garantía de fiabilidad futura. Veinte aciertos seguidos tampoco significan que el intento siguiente vaya a acertar.
Repetir la prueba desde el mismo estado y comprobar el resultado real ya aporta valor aunque no ajustes pesos. La guía de evaluación exige intentos completos, sin duplicados ni errores de infraestructura, antes de calcular la puntuación. Un fallo del servidor y una acción equivocada del agente necesitan diagnósticos distintos.
El salto al entrenamiento es bastante mayor. La configuración de referencia utiliza 24 GPU H100 y servicios para las herramientas, el usuario simulado y el juez. El repositorio aporta código y ejemplos públicos; estos no son el conjunto de 187 tareas empleado en el entrenamiento anunciado.
Empezaría por definir qué debe cambiar, qué debe conservarse y cómo comprobar ambas cosas. Si todavía no puedes distinguir un pedido bien actualizado de uno mal modificado, el entrenamiento no resuelve ese criterio por ti.