Agentes de IA
Google Harness²: tus agentes pueden mejorar sin tocar el modelo
Harness² prueba cambios en instrucciones, herramientas y memoria para mejorar un agente. Así funciona su doble recursión y qué límites conviene conocer.
La mejora puede estar en cómo trabaja el agente
Un agente que repite una consulta rota o pierde datos al preparar un informe puede necesitar mejores instrucciones y herramientas. Harness², un proyecto de Google Research, explora cómo modificar ese entorno mientras mantiene fijos los pesos del modelo.
Ese entorno se llama harness o arnés. Incluye el prompt del sistema, las reglas de trabajo, la memoria, la guía de herramientas, los subagentes, las skills, los scripts y los plugins. Harness² permite editar esas ocho piezas para probar otras formas de resolver una tarea.
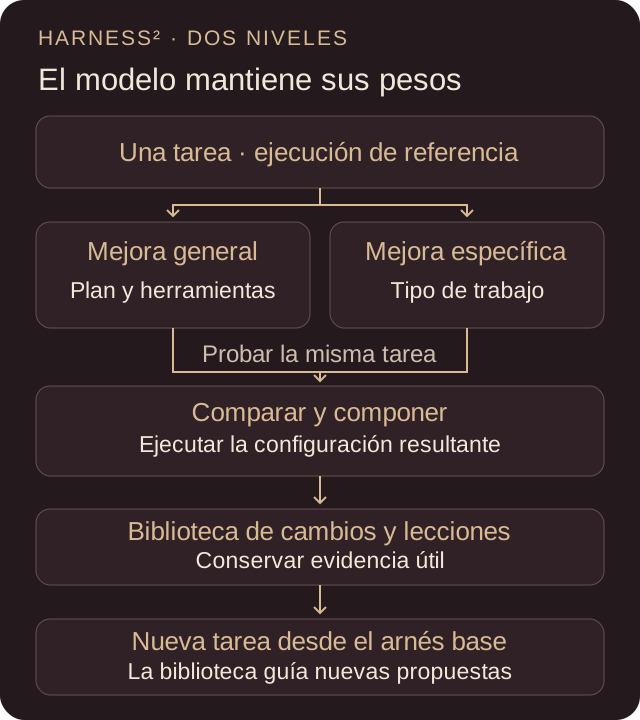
El paper se presentó el 9 de octubre de 2026. El cuadrado del nombre alude a dos niveles de mejora.
Proponer, probar y componer
Primero se conserva una ejecución de referencia. Después, un editor propone dos configuraciones: una dirigida a problemas generales, como planificar o usar herramientas, y otra adaptada al tipo de trabajo. Ambas vuelven a ejecutar la misma tarea en condiciones comparables.
El sistema contrasta sus pasos y entregables. A partir de esa evidencia compone otra configuración, que también ejecuta. Puede combinar cambios, corregirlos o conservar la configuración anterior si las propuestas no ayudan.
Comparar intentos no requiere una respuesta correcta de referencia, pero tampoco valida el resultado. Dos ejecuciones pueden compartir el mismo error. Se prueban cambios en la forma de trabajar, no una garantía de acierto.
Un informe con temperaturas que no se pueden comparar a simple vista
Imagina un informe que reúne lecturas de varios ficheros. Uno contiene 18 °C y otro 68 °F. Comparar 18 con 68 sin mirar las unidades produciría una conclusión equivocada: 68 °F equivalen a 20 °C.
Una propuesta general podría añadir una comprobación de unidades antes de redactar. La propuesta específica podría incorporar un script para convertir las temperaturas. Al repetir la tarea, habría que revisar qué valores conserva cada intento, cómo transforma los datos y si explica bien el resultado.
La composición podría reunir la comprobación y el script. Es un ejemplo hipotético: generar código no garantiza que la fórmula esté bien ni que el fichero se haya leído correctamente. El cálculo y las entradas siguen necesitando comprobación.
Lo aprendido sirve para decidir qué probar después
El segundo nivel conserva configuraciones adoptadas y lecciones respaldadas por lo observado. Cada entrada incluye un archivo EXPERIENCE.md que explica en qué situación sirvió un cambio y con qué evidencia.
La tarea siguiente empieza desde el arnés base. La biblioteca ayuda a proponer y adaptar mejoras; no se hereda automáticamente toda la configuración de la tarea anterior. Así se intenta aprovechar la experiencia sin arrastrar una solución demasiado específica.
También puedes ampliar el presupuesto de búsqueda. El modo paralelo explora más propuestas; el secuencial encadena revisiones. Ambos añaden ejecuciones y consumo de modelos, aunque el paralelismo pueda reducir el tiempo de espera.
Qué demuestra y qué falta comprobar
Los autores informan de mejoras con GLM-5 y Gemini 3.5 Flash en tres benchmarks profesionales: WorkBuddy-Bench, JobBench y LAB. Esos resultados no garantizan una mejora en tu aplicación ni acreditan una prueba independiente.
El repositorio incluye una demostración local sin credenciales, pero utiliza editores deterministas. Sirve para recorrer el mecanismo, no para medir cómo aprende un modelo real. Las ejecuciones conectadas a modelos sí generan costes de API.
Es código de investigación y el propio repositorio aclara que no es un producto con soporte oficial de Google. Además, documenta acceso de red sin restricciones y el ejecutor Codex con su sandbox desactivado. Lo probaría en un entorno aislado, con accesos acotados y sin credenciales de producción.
La idea útil es comparar cambios pequeños con evidencia y conservar solo lecciones que puedan revisarse. Antes de ampliar la autonomía, comprobaría el resultado, el coste y los permisos por separado. Mejorar el arnés no debería permitir que el sistema se conceda nuevos accesos.