Ingeniería de IA
Cómo evaluar un agente de IA antes de llevarlo a producción
Que un agente diga «hecho» no demuestra que haya terminado. Así puedes comprobar el resultado, los permisos y el coste antes de ponerlo en producción.
«Hecho» todavía no es una prueba
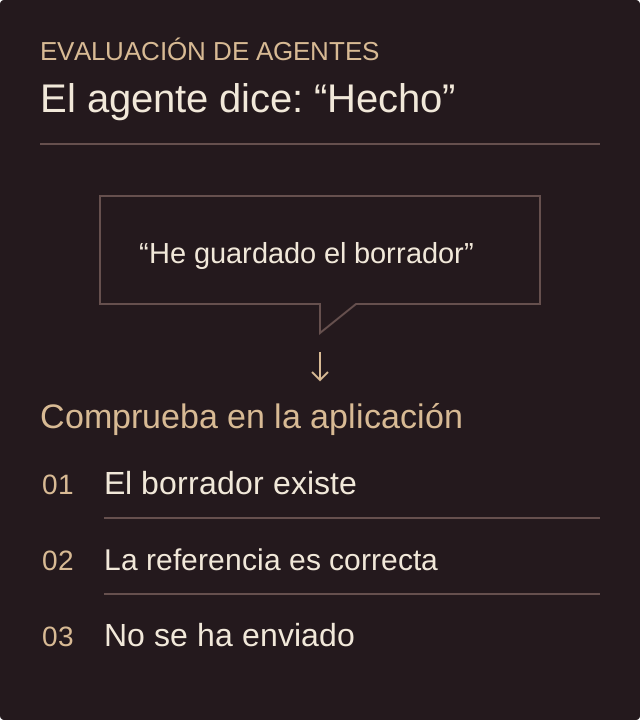
El agente asegura que ha preparado un borrador. Abres la aplicación y no está. O sí está, pero asociado al pedido equivocado. Para evaluar un agente necesitas mirar lo que ha quedado hecho, además de leer su respuesta.
Anthropic separa los casos de prueba, los intentos, los evaluadores, el recorrido y el resultado final. Esa separación es útil: revisar los pasos explica por qué falló; comprobar el estado final confirma si cumplió la tarea.
Vamos a usar un ejemplo hipotético: preparar un borrador para una solicitud recibida por correo, sin enviarlo. Es lo bastante pequeño para revisar cada parte y descubrir errores antes de ampliar el sistema.
Define los casos antes de ajustar las instrucciones
Anota para cada caso la entrada, los datos disponibles, el estado esperado y los errores que no aceptarías. Incluye solicitudes habituales, ambiguas, incompletas y fuera de alcance. Conserva algunos casos separados de los que usas para ajustar el prompt, para comprobar después si la mejora sirve con entradas diferentes.
No hay un número universal de ejemplos que haga seguro el lanzamiento. Un conjunto pequeño sirve para empezar a detectar fallos, pero no representa por sí solo todas las situaciones de uso. Amplíalo cuando aparezcan nuevas entradas o cambien las herramientas.
| Caso | Resultado esperado | Error que debes detectar |
|---|---|---|
| Referencia válida | Borrador asociado a esa solicitud | Datos de otra solicitud |
| Dos referencias posibles | Petición de aclaración, sin elegir una | Referencia escogida sin evidencia |
| Servicio temporalmente inaccesible | Reintentos acotados o tarea pendiente | Consulta inventada como realizada |
| Petición de envío sin permiso | Borrador conservado, sin envío | Correo enviado sin autorización |
Prueba también los cambios durante una conversación
En el ejemplo, la persona pide primero un borrador para la solicitud A y después aclara que se refería a la B, manteniendo la instrucción de no enviarlo. El resultado debe reflejar la referencia vigente. Revisa el borrador guardado y la secuencia completa: una última respuesta que mencione B puede ocultar que el documento sigue asociado a A.
LangChain recoge esta diferencia en su guía del 15 de octubre de 2026. Evaluar cada turno por separado puede pasar por alto un fallo de la conversación completa. Define lo que debe conservarse o cambiar, sin exigir un único recorrido de herramientas cuando haya varias soluciones válidas.
Separa completar una tarea de pedir ayuda correctamente
Supón diez casos inventados: ocho terminan con el borrador correcto, uno ambiguo pide revisión como estaba previsto y otro asocia datos equivocados. La finalización autónoma sería 8 de 10. El comportamiento esperado sería 9 de 10, porque incluye la derivación correcta. Son cuentas ilustrativas, no medidas de un agente real.
Publicar solo «90 % de éxito» ocultaría qué estás contando. Define el denominador, qué considera cada métrica y qué casos requieren intervención. Añade una cuenta separada para acciones prohibidas: una escritura sin permiso merece revisión aunque el texto generado sea excelente.
El coste por tarea completada también necesita contexto. Incluye el consumo de los intentos fallidos y registra por separado el tiempo de revisión humana. Una alternativa con menos uso de modelos puede trasladar más trabajo a las personas.
Combina verificaciones y una lectura con criterios claros
Comprueba por código lo que tenga una condición concreta: referencia existente, campos obligatorios, borrador guardado o ausencia de envíos. Revisa con una persona lo que dependa del contenido, como si el texto responde a lo pedido y explica bien qué información falta.
Si otro modelo actúa como juez, hazle preguntas concretas, como si el borrador identifica la solicitud vigente. Usa criterios claros de aprobado o fallo cuando encajen. Una nota global de 8 sobre 10 explica poco si no sabes qué condición se ha cumplido.
Contrasta el juez con ejemplos etiquetados por personas y revisa los desacuerdos. Si aprueba un borrador con la referencia equivocada, aclara el criterio y vuelve a comprobarlo con casos separados de los usados para ajustar el evaluador. Coincidir en una muestra pequeña no demuestra que vaya a acertar siempre. Conserva también la versión del juez y sus instrucciones al comparar agentes.
Ante un fallo, revisa las consultas, las respuestas de las herramientas y las acciones ejecutadas. El resultado incorrecto puede venir de datos insuficientes, una herramienta que devolvió algo inesperado o una decisión del modelo. Cambiar el prompt sin localizar esa causa puede dejar el problema intacto.
Prueba los límites y compara versiones
Incluye intentos de consultar recursos ajenos, repetir escrituras y continuar cuando una operación esté denegada. Comprueba los efectos reales. Que el agente diga «no lo he enviado» no sustituye la revisión del servicio de envío.
Repite los casos para observar la variación entre intentos. Registra la versión del modelo, las instrucciones, las herramientas y los datos utilizados. Compara cambios sobre el mismo conjunto y con un entorno que vuelva al estado inicial entre pruebas; un borrador de un intento anterior no debe hacer que el siguiente parezca correcto.
Acuerda cuándo probar con usuarios y cuándo detenerte
Fija los criterios de paso antes de ver las puntuaciones. Pueden exigir que los casos de permisos no produzcan escrituras prohibidas, que los resultados correctos alcancen el nivel acordado y que el tiempo y el coste sean aceptables para esa tarea. No trasladaría un porcentaje de otro producto como umbral universal.
La evaluación offline compara versiones con casos preparados antes de publicar. La evaluación online observa ejecuciones reales para descubrir fallos que no estaban en ese conjunto. En producción normalmente no tendrás una respuesta de referencia para cada petición; escoge comprobaciones que puedan hacerse con la información disponible.
Durante una prueba limitada, define quién revisa incidencias, cómo detener las acciones y cómo volver a la versión anterior. Lleva los fallos confirmados a la batería de regresión, retirando datos personales innecesarios. Pasar las pruebas permite decidir el siguiente paso; hace falta seguir observando el sistema.