Modelos de IA
Step 5 Preview usa más capas para abordar tareas largas
StepFun explica cómo combina 92 capas, atención selectiva y compactación del contexto para trabajar con agentes. Qué cambia y qué exige desplegar sus pesos.
Seguir trabajando después de muchas llamadas a herramientas
Step 5 Preview está pensado para tareas que requieren consultar información, ejecutar herramientas y corregir el rumbo varias veces. StepFun publicó el 15 de octubre los detalles de su arquitectura y entrenamiento. Además del acceso por API, sus pesos están disponibles para descargarlos.
Es un modelo de mezcla de expertos, o MoE, con 600.000 millones de parámetros totales y 27.000 millones activos por token. Admite hasta un millón de tokens de contexto, las unidades con las que procesa la entrada. Son cifras de capacidad, no una garantía de que vaya a resolver una tarea larga sin errores.
Más profundidad y dos formas de mirar el historial
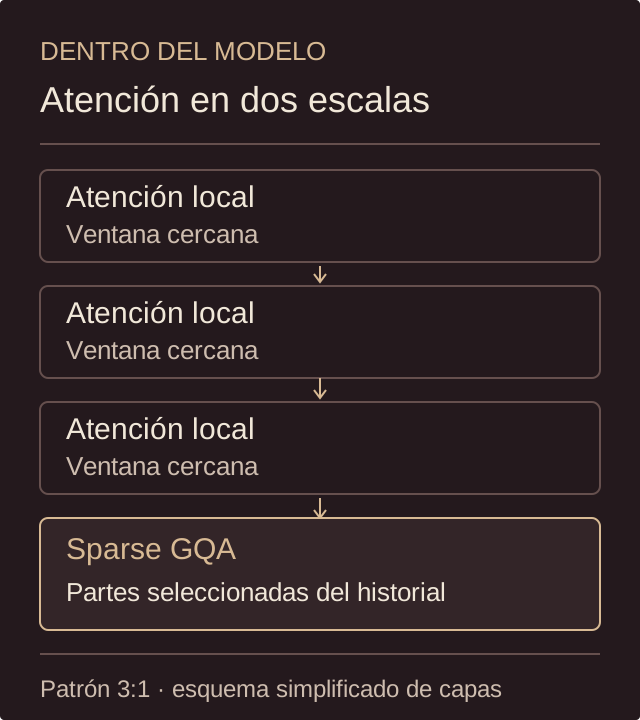
El diseño tiene 92 bloques de transformación para procesar dependencias entre pasos. Combina tres capas de atención local con una que consulta partes seleccionadas del historial, un mecanismo llamado Sparse GQA.
La atención local trabaja con una ventana cercana. La otra consulta información más lejana. Así se busca contener el coste de procesar contextos largos, aunque el rendimiento también depende del entorno de ejecución.
Tener mucho contexto no evita tener que organizarlo
StepFun también entrena al agente para reorganizar el trabajo en un estado desde el que continuar cuando está a punto de agotarse el contexto. Esa compactación se aprende con la recompensa de la tarea.
Imagina una migración de código que afecta a varios módulos. Tras revisar archivos y ejecutar pruebas, el historial acumula salidas que ya no hacen falta. Para continuar, sería útil conservar qué archivos cambió, qué pruebas pasaron, cuáles fallaron y qué queda pendiente. Un resumen como «la migración está casi terminada» perdería justo la información necesaria para retomarla.
Es un ejemplo propuesto. Para valorar un sistema así, comprobaría si conserva el fallo pendiente después de compactar, no solo si produce menos texto. Y mantendría los cambios y resultados de pruebas en archivos o registros comprobables. El modelo no accede por sí solo al repositorio: las herramientas y su ejecución las aporta la aplicación que lo integra.
Los pesos están disponibles, con requisitos importantes
La ficha incluye despliegues con vLLM y SGLang. Uno de sus ejemplos FP8 utiliza cuatro GPU B300; otro, ocho H200. Los 27.000 millones de parámetros activos no convierten el modelo completo en uno pequeño: la memoria necesaria cambia con el formato, la concurrencia y el contexto que quieras mantener.
Además, usa StepFun Model License 1.0, con condiciones propias de atribución y licencia comercial. Que sus pesos puedan descargarse no significa que tenga la licencia Apache 2.0 sin añadidos. Antes de integrarlo en un producto conviene revisar esas condiciones y elegir una versión del motor de inferencia que incluya soporte para Step 5 Preview.