Ingeniería de IA
Dory: un modelo pequeño que vuelve a pasar por las mismas capas
NVIDIA publica Dory 1.0 4B, un modelo que reutiliza capas para dedicar más cálculo a una respuesta. Cómo funciona y qué falta para ejecutarlo con facilidad.
Más pasadas por el mismo bloque
NVIDIA ha publicado Dory 1.0 4B, un modelo de texto que puede repetir un bloque de sus propias capas mientras genera la respuesta. En lugar de cargar un modelo distinto para dedicar más cálculo a una tarea, permite variar cuántas veces recorre ese bloque. Los pesos se publicaron el 16 de octubre.
La idea se conoce como arquitectura recurrente en el espacio latente. Aquí significa que se repite procesamiento interno. No consiste en enviar varias veces la misma pregunta a un chatbot ni en pedirle que escriba una explicación más larga.
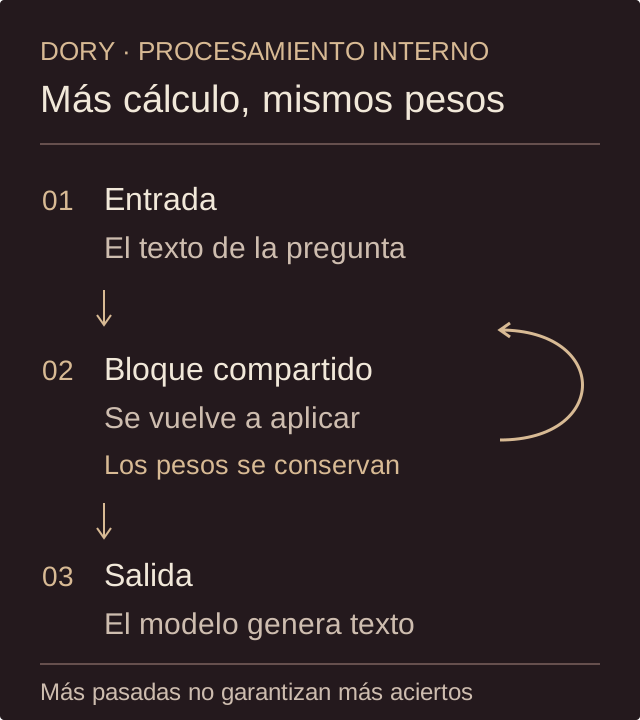
Repetir cálculo no garantiza acertar más
Su ficha compara una, dos y cuatro pasadas. NVIDIA propone empezar con dos, aunque los resultados no mejoran de forma uniforme en todas las pruebas. Son mediciones del fabricante. Aumentar las pasadas añade cálculo por token, pero el modelo también puede generar menos texto; la duración completa de una tarea hay que medirla.
Los 4.000 millones de parámetros describen el tamaño del modelo. Reutilizarlos varias veces no lo convierte en uno de 8.000 o 16.000 millones con pesos diferentes. Tampoco indica por sí solo cuánta memoria necesitará toda la ejecución.
Una pregunta con dos condiciones
Imagina una herramienta que prepara el orden de unas tareas. Tiene que proponer una reunión después de recibir un documento y antes de una fecha límite. Podrías comparar el mismo caso con una, dos y cuatro pasadas, dejando el resto igual. No se trata de comprobar si la respuesta suena más razonada, sino de verificar que respeta las dos condiciones.
Añadiría otro caso en el que el documento llega después del plazo. Ahí lo correcto sería explicar que no existe un hueco válido, en lugar de inventar una reunión posible. Es una prueba propuesta, no un resultado obtenido con Dory.
Esa comparación permite decidir si merece la pena esperar más en una tarea concreta. También deja ver si la configuración más costosa conserva errores que una respuesta más extensa podría disimular. Para fechas y restricciones cerradas, un validador convencional puede comprobar el resultado antes de que la aplicación actúe.
Publicado no significa integrado en cualquier aplicación
El soporte de Dory en vLLM sigue en una propuesta de integración abierta. En llama.cpp la propuesta está en borrador. Las instrucciones actuales recurren a código específico de esas integraciones; no basta con instalar una versión estable cualquiera y asumir que reconocerá el modelo.
Además, la ficha declara inglés como idioma soportado y licencia OpenMDW 1.1. Una aplicación en español necesita comprobar sus propias entradas. Dory resulta interesante por la posibilidad de ajustar el cálculo manteniendo los pesos, pero tanto la integración como la utilidad de cada ajuste siguen formando parte de la decisión.