Modelos de IA
Mercury 3 genera texto por difusión
Qué es la difusión de texto de Mercury 3, cómo cambia su streaming y por qué generar más tokens por segundo no asegura terminar antes una tarea con agentes.
La difusión también sirve para generar texto
Mercury 3 es un modelo de lenguaje de Inception, anunciado el 19 de octubre y disponible por API. Su diferencia está en cómo genera la respuesta: usa difusión para refinar varias posiciones del texto en paralelo. La familia Mercury ya utilizaba este enfoque; la nueva versión amplía sus capacidades y el contexto que puede manejar.
En la generación autorregresiva, cada nuevo token, un fragmento de texto, se apoya en los anteriores. La difusión parte de un estado con ruido y lo va refinando. La red puede proponer cambios en varias posiciones durante un mismo paso. Eso permite explorar otra forma de acelerar la generación, sin que el método garantice por sí solo una respuesta correcta.
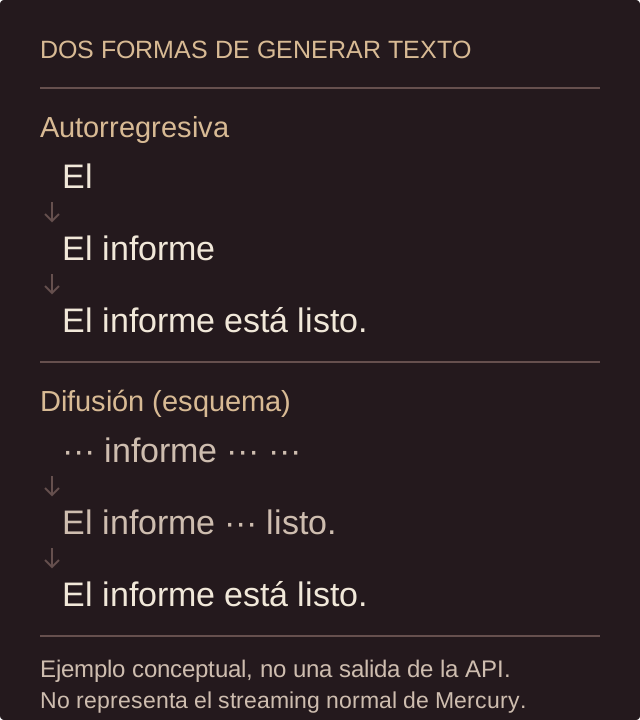
El streaming normal no enseña cada borrador
La API permite recibir bloques de texto ya refinado mediante streaming, sin esperar a la respuesta completa. También ofrece un modo opcional, diffusing, que muestra estados intermedios del proceso. En ese modo cada fragmento recibido contiene el texto completo de ese estado, no solo unas palabras nuevas.
La diferencia importa al crear la interfaz. Con el modo de difusión, la documentación indica que se sustituya el texto mostrado en cada paso. Si se concatenaran todos los estados, aparecerían versiones repetidas del mismo contenido. Para un chat corriente usaría el streaming normal; mostrar el refinamiento tiene sentido cuando se quiere explicar o visualizar ese proceso.
Un agente también espera a sus herramientas
Imagina un asistente que prepara el resumen semanal de incidencias. Primero consulta los tickets, después agrupa lo ocurrido y finalmente escribe un borrador. Generar ese texto más deprisa puede acortar una parte del trabajo. Si la espera principal está en la API de tickets, cambiar el modelo dejará ese cuello de botella.
Mercury 3 admite llamadas a herramientas. La aplicación ejecuta la función solicitada y devuelve el resultado para que el modelo continúe. Puede pedir varias operaciones independientes en una respuesta, pero una consulta que necesita el resultado de otra conserva esa dependencia. El paralelismo dentro del modelo no elimina el orden que exige la tarea.
Qué ofrece la versión disponible
La referencia de Mercury 3 ofrece un millón de tokens de contexto, llamadas a herramientas y salidas ajustadas a un esquema JSON. Admite texto y permite graduar el esfuerzo de razonamiento. Esas funciones dan puntos concretos para compararlo con el modelo que ya usa una aplicación.
Inception publica una velocidad de 1.068 tokens por segundo en GPU de NVIDIA. Es una cifra comunicada por el fabricante, no una medición realizada aquí ni el tiempo de respuesta de un producto completo. Para el asistente del ejemplo compararía el resumen final, los errores y el tiempo desde la petición hasta el borrador aceptable.