Ingeniería de IA
llm-d 1.0 organiza el tráfico cuando muchos agentes comparten modelo
llm-d 1.0 añade prioridades, reparto entre usuarios y continuidad de sesiones a la inferencia distribuida. Qué cambia cuando un chat comparte recursos con lotes de IA.
Servir un modelo también es decidir quién espera
llm-d publicó la versión 1.0 el 20 de octubre. Es una capa de infraestructura para servir modelos en Kubernetes, el sistema que coordina aplicaciones en un conjunto de servidores. Organiza las peticiones que llegan a motores como vLLM o SGLang, responsables de ejecutar el modelo.
La versión incorpora control de tráfico por prioridad y reparto entre usuarios o cargas de trabajo. También estabiliza en v1 la API de configuración del router. El problema que aborda se reconoce enseguida: un agente puede lanzar muchas peticiones mientras otra persona espera una respuesta en un chat.
Un chat y un lote de informes comparten recursos
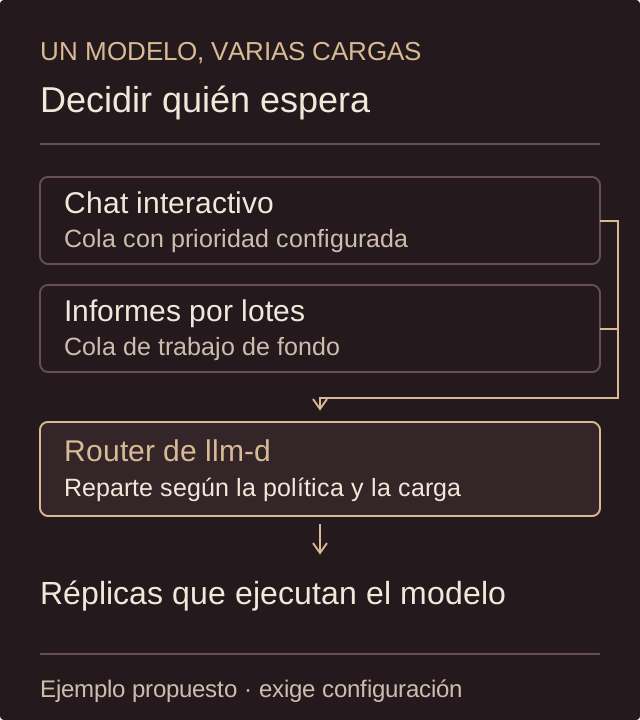
Imagina una aplicación que responde preguntas y también prepara informes por lotes. Si todas las peticiones entran en una misma cola, el lote puede hacer esperar a quienes están conversando. Podrías dar más prioridad al chat y repartir capacidad entre los distintos clientes del servicio.
llm-d 1.0 permite expresar esas políticas mediante flowControl. Conserva colas separadas y reparte los turnos dentro de cada nivel de prioridad. Hay un detalle importante: por defecto mantiene un comportamiento equivalente al orden de llegada. Instalar la versión no activa por sí solo una política de prioridades adaptada a tu aplicación.
El historial ya procesado también influye en el reparto
El router puede elegir una réplica teniendo en cuenta su carga y la caché KV que conserva, los resultados intermedios usados al procesar el contexto. Reutilizar esa información puede evitar parte del cálculo de una conversación que continúa. No es una memoria de preferencias del usuario ni equivale a resumir el historial.
La versión refuerza el tratamiento de sesiones: intenta mantener los turnos cerca de la réplica que ya tiene su contexto y permite cambiar de destino cuando se satura. Así entra en la decisión tanto el trabajo reutilizable como la capacidad disponible. Enviar siempre todo al servidor con más caché también podría convertirlo en un cuello de botella.
Qué conviene comprobar antes de adoptarlo
El lanzamiento incluye alta disponibilidad del router y coordinación de actualizaciones. Eso no equivale a recuperar automáticamente cualquier petición que falle en mitad de su ejecución: la recuperación y migración de peticiones sigue apareciendo entre los próximos pasos del proyecto.
En el ejemplo del chat y los informes, mediría cuánto esperan los usuarios durante un lote, cuántas solicitudes fallan y cuánto tarda ese lote en terminar. Dar prioridad al chat puede retrasar el trabajo de fondo; conviene comprobar ambos lados del reparto. Son criterios propuestos, no resultados medidos aquí.
llm-d encaja en equipos que operan su propia infraestructura de inferencia. Si tu aplicación consume una API alojada, esa capa la gestiona el proveedor. La novedad no obliga a montar un clúster para usar agentes: ayuda a resolver un problema de capacidad y operación cuando ese problema existe.