Agentes de IA
Eleven Realtime simplifica la creación de agentes de voz
ElevenLabs presenta v1 Mini y Max para coordinar voz, turnos y respuestas. Qué cambia, cómo se integran y por qué siguen siendo varios modelos en cascada.
Menos piezas que ajustar por separado
ElevenLabs presentó Eleven Realtime el 20 de octubre, con dos opciones para crear agentes de voz: v1 Mini y v1 Max. En ElevenAgents, elegir una de ellas reúne el reconocimiento del habla, el modelo de lenguaje y la voz de respuesta bajo una configuración gestionada. El despliegue es gradual y puede que todavía no aparezca en tu espacio de trabajo.
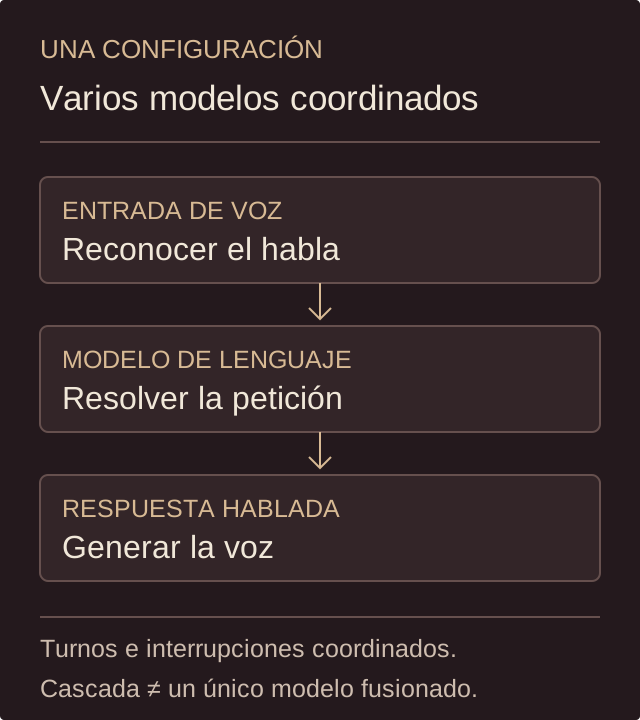
La idea es reducir el trabajo de coordinar cuándo escuchar, cuándo responder y cómo retomar una conversación tras una interrupción. No significa que todo ocurra dentro de un único modelo: la documentación describe una arquitectura en cascada, con modelos distintos optimizados para funcionar juntos. Los detalles de esos componentes no son públicos.
Mini para conversar; Max para tareas con más pasos
Mini se orienta a conversaciones naturales, como las de un tutor o un asistente. Max añade razonamiento para instrucciones complejas y tareas con varias llamadas a herramientas. Esta es la orientación del lanzamiento, no una garantía de que Max sea mejor para cualquier conversación.
En ElevenAgents puedes seguir definiendo instrucciones, voz, herramientas y base de conocimiento. Lo que cedes es la elección separada del modelo de lenguaje, el reconocimiento del habla y el modelo de voz. Si necesitas elegir un componente concreto o ya usas un modelo personalizado, el modo Custom sigue siendo la opción adecuada.
Una corrección de talla cambia la tarea
Imagina una llamada a una tienda de calzado: «¿Tenéis este modelo en la 42? Perdona, quería decir la 43». El agente debería recoger la corrección y consultar la talla 43. Si sigue contestando sobre la 42, una voz agradable no habrá resuelto la consulta. Es un ejemplo hipotético de lo que conviene probar, no una llamada realizada con estos modelos.
La gestión de interrupciones también depende de las herramientas. ElevenAgents permite configurar si se puede interrumpir mientras se ejecutan y durante la respuesta posterior. Para una consulta de existencias dejaría margen para corregir la petición. Si después se ofrece reservar un par, comprobaría que la talla confirmada coincide con la que se guarda.
La plataforma y la API ofrecen cosas distintas
También hay una API Realtime por WebSocket, una conexión persistente para intercambiar eventos y audio. Funciona por separado de ElevenAgents: no hereda sus canales ni su base de conocimiento. Si necesitas esas funciones de la plataforma, el anuncio recomienda empezar directamente en ElevenAgents. Una integración que use WebRTC requiere cambiar el transporte para usar esta API.
En ElevenAgents, la factura suma la tarifa por minuto de la plataforma y los tokens del modelo Realtime; Max cuesta más por token que Mini. Al comparar alternativas, miraría cuánto tarda una consulta completa y cuántas termina bien. Empezar a hablar rápido y resolver correctamente la petición son medidas diferentes.