Actualidad de IA
IBM reúne chat, decisiones y voz en Granite Switch 4.1
Una aplicación puede transcribir un mensaje, clasificarlo y responder desde un mismo servicio. Granite Switch 4.1 reúne esas piezas, con un límite importante en el audio.
Varias tareas detrás de una misma conexión
Un cliente deja una nota de voz. La aplicación tiene que pasarla a texto, entender qué pide y preparar una respuesta. Son tareas distintas que suelen acabar conectadas. Con Granite Switch 4.1, IBM propone servirlas desde un mismo endpoint, la dirección a la que tu aplicación envía las peticiones.
IBM presentó la propuesta el 15 de octubre de 2026. Las fichas de los modelos 8B y 30B sitúan su lanzamiento el día 14. El interés está en reunir las capacidades sin tener que tratar cada una como un servicio separado.
El modelo cambia de especialidad
Granite Switch combina un modelo base con adaptadores, piezas entrenadas para una función concreta. Incluye decision para elegir entre opciones y guardian-core para comprobaciones de seguridad, además del componente de voz. La aplicación selecciona qué capacidad utiliza en cada paso.
Los adaptadores aLoRA pueden reutilizar la caché del contexto anterior compatible. Así se evita repetir parte del cálculo. Eso no hace intercambiables todas las respuestas: una categoría, una transcripción y un mensaje de chat tienen usos distintos.
La palabra que no puedes perder
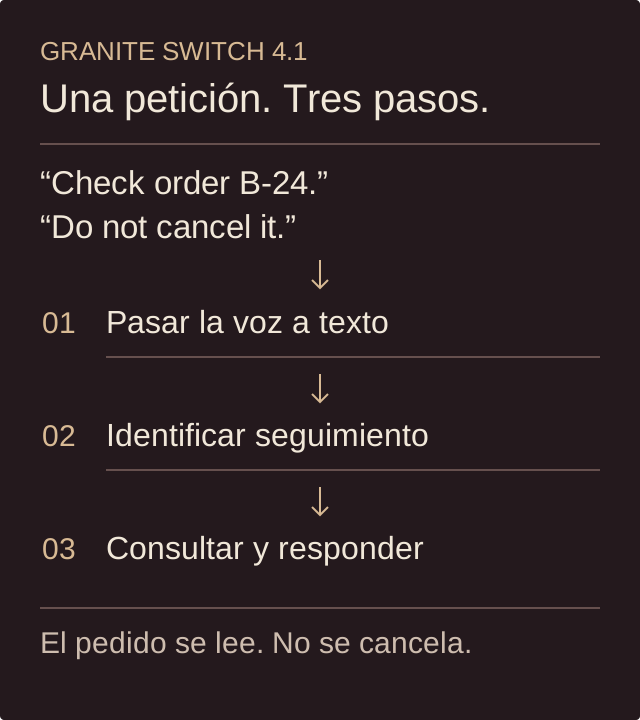
Imagina una nota de prueba en inglés: «Please check order B-24. Do not cancel it». El sistema debería transcribirla, identificar una consulta de seguimiento y preparar la respuesta. Para comprobar el estado del pedido necesitaría una herramienta de lectura; no necesita permiso para cancelarlo.
Aquí la negación lo cambia todo. Si se pierde al transcribir, el resto del recorrido puede parecer coherente y terminar mal. La prueba tendría que comprobar el texto, la categoría y que el pedido sigue intacto. Es un caso propuesto, no un resultado medido con el modelo.
El audio incluido está pensado para inglés
La ruta de audio sigue marcada como alpha. Primero un componente ASR convierte el sonido en texto y después el modelo trabaja con esa transcripción. La documentación advierte de inglés, minúsculas y ausencia de puntuación. Un error en ese primer paso puede pasar al siguiente sin avisar.
Si tu aplicación trabaja en español, este límite importa desde el principio. Puedes estudiar otro transcriptor compatible, pero que el modelo converse en español no demuestra que el componente de voz incluido entienda ese idioma.
Qué queda por poner de tu parte
Los modelos se publican bajo Apache 2.0, con documentación para Transformers y vLLM. Necesitas infraestructura y versiones compatibles. Además, guardian-core no incluye todas las comprobaciones de hechos o políticas disponibles en otros adaptadores del catálogo.
La prueba más útil sería la misma nota de voz en tu solución actual y en esta alternativa. Compara errores, tiempo total y memoria con varias peticiones a la vez. Las cifras de IBM sirven de referencia; no sustituyen esa comparación ni permiten quitar los controles de acceso de la aplicación.