Modelos de IA
TRL permite destilar varios especialistas y vigilar el reparto de tokens
MOPD asigna un profesor a cada consulta del alumno. Por qué un reparto de prompts puede ocultar un desequilibrio de tokens y qué revisar antes de entrenar.
El reparto de consultas no cuenta toda la historia
TRL incorpora destilación con varios profesores en su entrenador asíncrono experimental. Cada consulta se asigna a un especialista, que puntúa la respuesta generada por el modelo alumno. Así se pueden trasladar capacidades de varios profesores a un único modelo sin consultarlos a todos cuando el alumno ya está desplegado.
El artículo de Hugging Face del 3 de noviembre explica una dificultad práctica: repartir las consultas entre dominios no garantiza repartir de la misma forma los tokens que intervienen en el entrenamiento. Las respuestas largas pueden ocupar casi todos los tokens de entrenamiento aunque las cortas tengan una presencia visible en los datos.
El alumno responde y su especialista lo evalúa
MOPD significa Multi-Teacher On-Policy Distillation. La parte on-policy indica que el alumno aprende sobre sus propias respuestas: el profesor aporta una señal por token sobre lo que el alumno ha generado. No se limita a copiar un archivo de respuestas escritas previamente por otro modelo.
En TRL, la columna teacher_id elige qué profesor recibe cada muestra. Una consulta de código puede ir al especialista en programación y una de matemáticas al suyo. No se promedian las respuestas de todos los profesores para contestar cada petición: la combinación ocurre durante el entrenamiento.
Este recorrido exige compatibilidad. La documentación requiere que profesores y alumno compartan tokenizador, porque intercambian identificadores de tokens. Un nombre de dominio correcto no compensa una correspondencia incorrecta entre vocabularios.
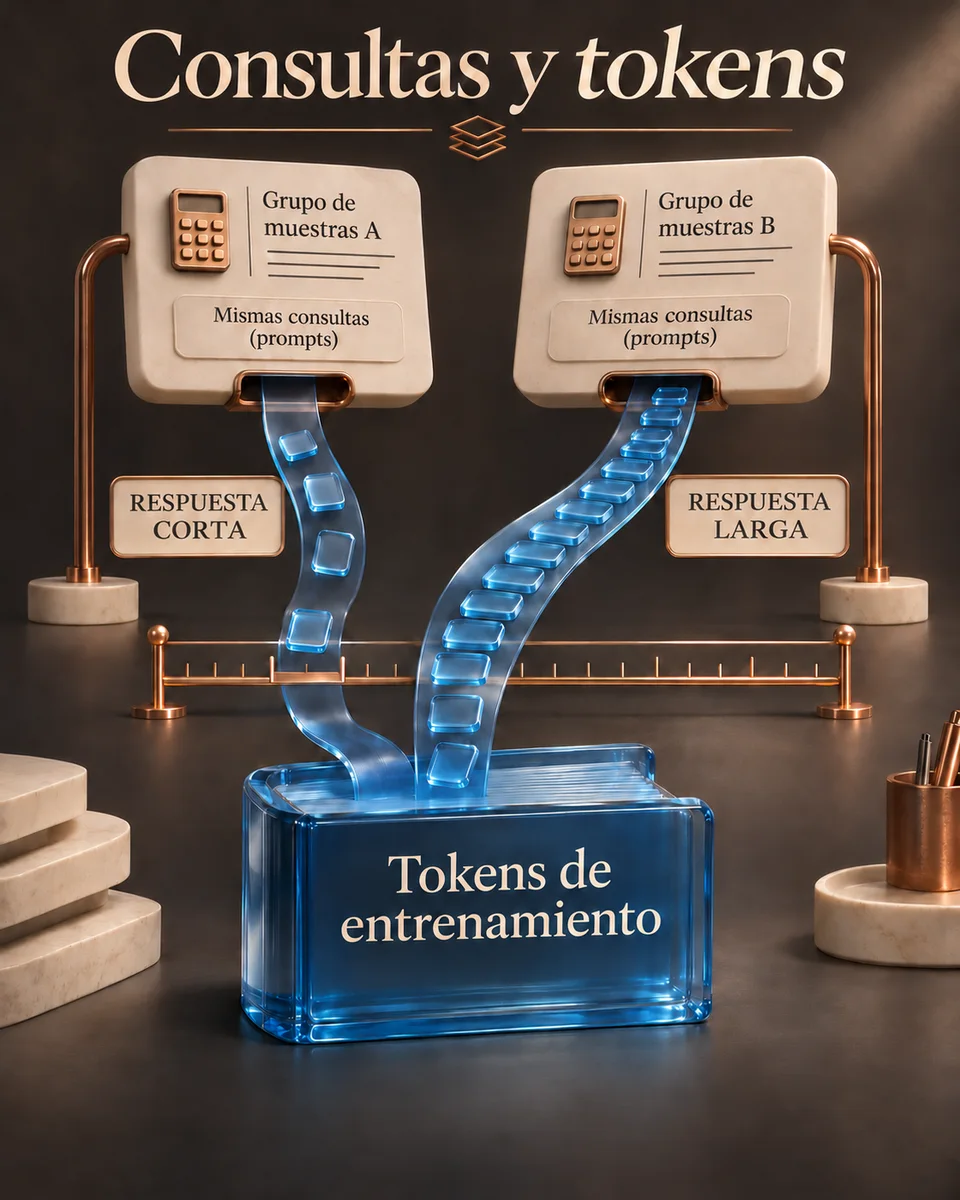
Veinte consultas pueden pesar solo un 2,44 %
En este ejemplo ficticio hay cien consultas. Veinte generan respuestas de 200 tokens y ochenta generan respuestas de 2.000. Suponemos que todos esos tokens reciben puntuación y entran en la pérdida, sin posiciones excluidas. El primer grupo aporta el 20 % de las consultas, pero solo 4.000 de los 164.000 tokens totales: aproximadamente un 2,44 %.
La cuenta ilustra por qué el muestreo puede parecer equilibrado y no serlo en la función que optimiza el modelo. No es un resultado medido de TRL ni una predicción de cuánto aprenderá cada habilidad. La longitud real y los tokens excluidos cambian el reparto.
Revisaría ese volumen antes de añadir más entrenamiento. Aumentar pasos puede repetir el mismo desequilibrio. Cambiaría una variable del muestreo y comprobaría por dominio si el alumno mejora también en las tareas de respuesta corta, sin dar por hecho que una media global representa a todos.
| Grupo ficticio | Consultas | Tokens por respuesta | Tokens totales |
|---|---|---|---|
| Respuesta corta | 20 | 200 | 4.000 |
| Respuesta larga | 80 | 2.000 | 160.000 |
| Total | 100 | No aplica | 164.000 |
Qué comprobar antes de incorporarlo
La documentación consultada corresponde a la rama main y sitúa AsyncDistillationTrainer en el espacio experimental. No equivale a una garantía de estabilidad ni confirma por sí sola que cualquier versión instalada incluya la misma función. Guardaría la revisión exacta utilizada antes de comparar ejecuciones.
El entrenador separa generación, puntuación del profesor y actualización del alumno. Los profesores se sirven mediante vLLM; hay coordinación y recursos adicionales, aunque el destino final sea un solo modelo. No empezaría este trabajo para resolver un problema que basta con corregir en el prompt o en los datos.
Cuando ya existan especialistas y tareas de evaluación propias, miraría teacher_token_frac por profesor para conocer su participación y teacher_jsd para seguir la divergencia respecto a él. Acercarse al profesor no certifica utilidad por sí solo. La decisión final necesita ejemplos resueltos por dominio y un coste de entrenamiento que tenga sentido para el uso previsto.