Evaluación de IA
StateBench evalúa si un modelo sigue los cambios de un documento
Encontrar un dato antiguo no basta para conocer el estado actual. El nuevo benchmark de Ai2 separa recuperar información de encadenar cambios correctamente.
El dato estaba en el historial, pero ya había cambiado
Un agente que consulta una conversación puede recuperar una decisión antigua y pasar por alto la corrección posterior. Ampliar el contexto le permite recibir más mensajes; no garantiza que reconstruya bien lo que sigue vigente. StateBench, presentado por Ai2 el 3 de noviembre, pone a prueba precisamente esa capacidad de seguir cambios.
La diferencia importa al evaluar un asistente que trabaja con documentos largos. Preguntar por un dato que aparece una vez comprueba si lo encuentra. Preguntar por el valor actual después de varias modificaciones exige conservar el efecto de cada paso. Son pruebas distintas, aunque ambas quepan dentro de la misma ventana de contexto.
Una actualización puede depender de todas las anteriores
El benchmark distingue cuatro dificultades: valores que permanecen fijos, valores que se sustituyen, actualizaciones que dependen del valor anterior y cambios que toman el valor actual de otra variable. Esa última operación obliga a seguir dependencias: localizar la última línea de una variable puede no resolver nada si remite a otra que también cambió.
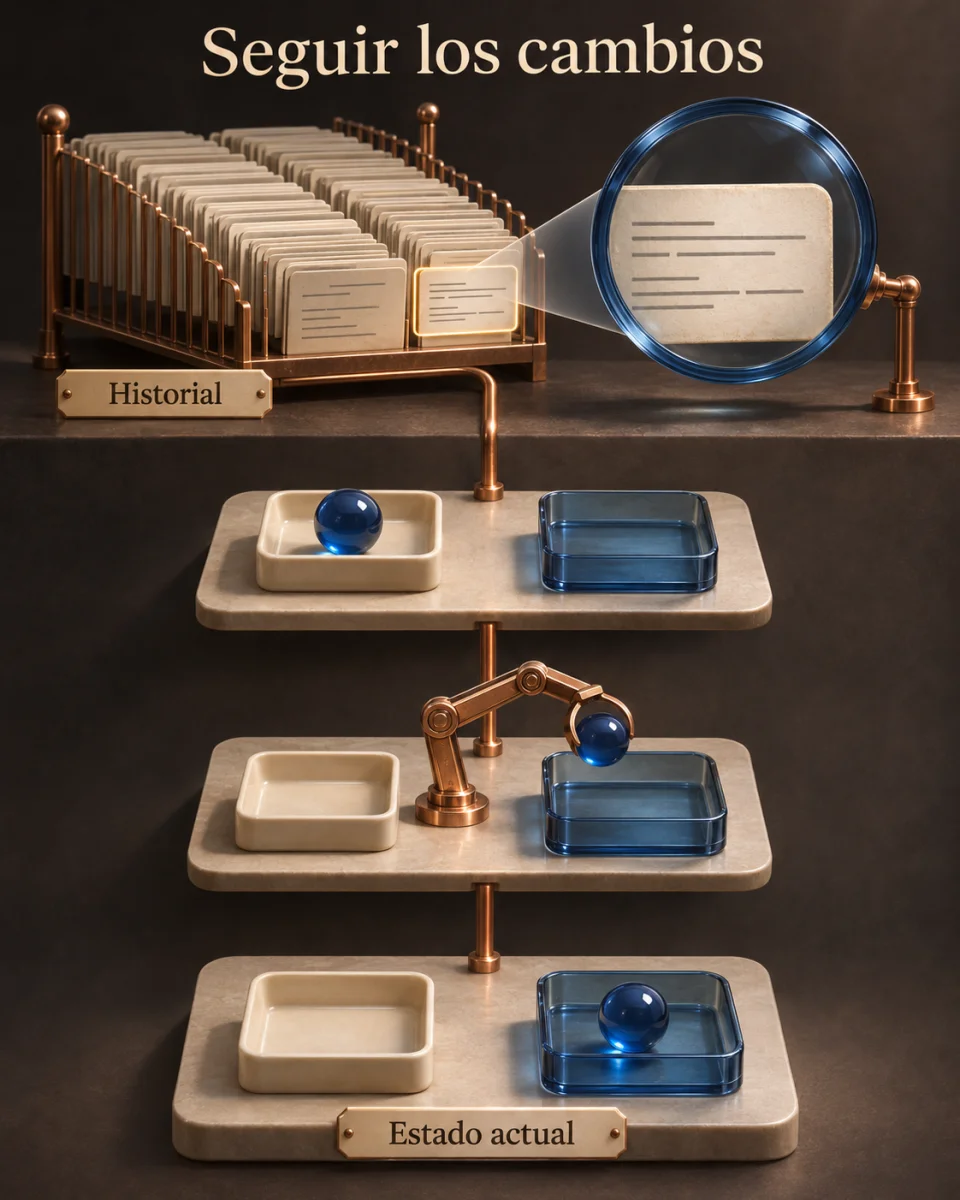
Un ejemplo pequeño permite verlo. A empieza en 8 y B en 3. Se transfieren dos unidades de A a B, por lo que quedan 6 y 5. Después se asigna a A el valor que tiene B en ese momento: el resultado es 5 y 5. Buscar únicamente la última mención de A devuelve una instrucción, no la respuesta. Este es un ejemplo ilustrativo propio, no una ejecución del benchmark.
El código de StateBench genera variantes relacionadas de una misma secuencia y permite representarlas en formatos diferentes. Así se puede estudiar cuánto pesa la dependencia entre operaciones y cuánto influye la forma de presentar el problema. Una evaluación que solo cambia la longitud del texto puede mezclar ambas cosas.
El resultado no convierte una arquitectura en ganadora universal
Ai2 publica resultados tanto de modelos ya entrenados como de modelos entrenados específicamente para estas tareas. En sus experimentos, los modelos recurrentes e híbridos generalizan mejor que los transformers en varios niveles al recibir entrenamiento directo. Los modelos de frontera evaluados también pierden precisión en las secuencias más difíciles cuando aumenta su longitud.
Son resultados del equipo investigador en tareas controladas, no una prueba independiente realizada para este artículo. Tampoco bastan para escoger el modelo de una aplicación completa: seguir estas asignaciones es una capacidad concreta. El propio trabajo mantiene fijo el número de variables, mientras que una conversación real puede introducir personas, objetos o asuntos nuevos.
Qué cambiaría en la evaluación de un agente
Además de pedir respuestas sobre un historial largo, prepararía casos con una corrección tardía, una cantidad actualizada varias veces y una decisión que dependa de otra. Comprobaría el estado final esperado y el punto en que deja de coincidir, en lugar de aceptar una respuesta porque cite un fragmento auténtico.
Para estados operativos, como existencias o el estado de una solicitud, mantendría un registro estructurado que la aplicación actualice mediante reglas comprobables. El modelo puede ayudar a interpretar una petición o explicar el historial; cuando hay una operación determinista, conviene ejecutarla y verificarla. Esta es una recomendación de diseño, no un resultado medido por StateBench.
El informe, el código y los datos ya están disponibles públicamente. Su utilidad inmediata está en añadir una pregunta a las evaluaciones: ¿el agente encuentra lo que ocurrió o calcula correctamente lo que sigue siendo cierto? Resolver la segunda exige algo más que entregar todos los mensajes.