Ingeniería de IA
Reintentos en agentes de IA: cómo evitar acciones duplicadas
Una herramienta tarda demasiado y el agente vuelve a intentarlo. Sin comprobar qué pasó, puede crear dos incidencias o enviar dos avisos.
Un timeout no confirma que la operación haya fallado
Le pides al agente que abra una incidencia. La herramienta tarda, se agota el tiempo de espera y no llega ninguna confirmación. ¿La incidencia no existe o se creó y se perdió la respuesta?
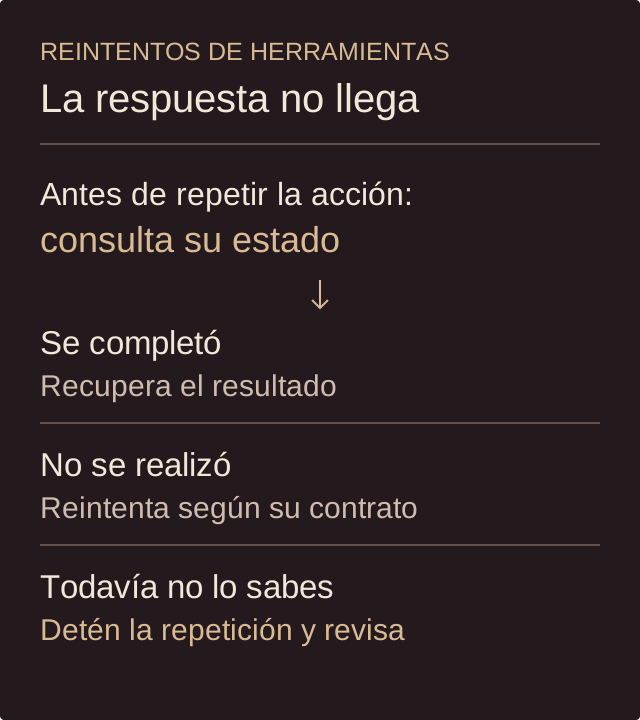
Un timeout solo confirma que no recibiste una respuesta a tiempo. La operación puede haberse completado. Repetirla sin comprobarlo puede crear una segunda incidencia.
Por eso los reintentos necesitan algo más que una instrucción para el modelo. La herramienta debe explicar cómo consultar el estado y cómo repetir una petición sin duplicar sus efectos.
Un ejemplo con una incidencia de soporte
Imagina un tablero de demostración donde un asistente registra que el buscador de una web no funciona. El servidor crea la incidencia, pero la conexión se corta antes de devolver su número. Si el asistente vuelve a pedir que la cree como una operación nueva, podrían aparecer dos tareas iguales.
En este ejemplo hipotético, la aplicación guarda un identificador para esa operación antes de enviarla. Si el destino admite idempotencia, el reintento reutiliza la misma clave para recuperar el resultado sin repetir la creación. Idempotencia significa aquí que repetir la misma operación no añade otro efecto.
Escribir un identificador en el prompt no basta. El servicio que crea la incidencia debe reconocerlo y coordinar la deduplicación con la escritura. También debe definir cuánto conserva las claves y qué ocurre si llegan peticiones simultáneas o con datos distintos bajo la misma clave.
Decide según el fallo y el efecto de la herramienta
Clasificar el error ayuda a elegir una salida. Leer de nuevo una ficha pública y repetir una escritura tienen consecuencias distintas. Estas son reglas de partida para revisar con el contrato de cada servicio, no una política universal basada solo en el código HTTP.
| Situación | Salida que conviene preparar |
|---|---|
| Fallo temporal al consultar datos | Reintentar con espera y límite si la operación lo permite |
| Argumentos inválidos | Corregirlos antes de volver a enviar la petición |
| Acceso denegado | Detener la acción y explicar qué autorización falta |
| Escritura enviada, resultado desconocido | Consultar su estado o reintentar con idempotencia acreditada |
Pon un límite a la recuperación completa
Una espera creciente entre intentos, llamada backoff, reduce las peticiones seguidas. Añadir una variación aleatoria, o jitter, ayuda a que muchos clientes no vuelvan a llamar a la vez. Revisa también los reintentos del SDK: varios niveles repitiendo pueden multiplicar las llamadas.
En LangChain, ToolRetryMiddleware permite seleccionar herramientas y errores, ajustar las esperas y decidir qué hacer al agotarlas. Devolver el error al modelo le permite seguir razonando; no detiene necesariamente el agente. Un límite por llamada necesita complementarse con límites del recorrido completo.
Para el tablero de prueba podrías permitir un envío inicial y un único reintento seguro, con un plazo total acordado. Es una política ilustrativa que debes ajustar con medidas. Limitar llamadas al modelo o herramientas tampoco fija por sí solo un coste en euros: cuentan los tokens, las tarifas y los servicios utilizados.
Al reanudar, recupera el estado de la operación
Si el proceso se reinicia, necesita recuperar la clave, los argumentos y el estado conocido de esa incidencia. Generar otra clave al reanudar haría que una petición repetida pareciera nueva. Si el destino no ofrece una garantía suficiente y no puedes confirmar el resultado, conserva la tarea como pendiente de revisión.
LangGraph permite guardar el estado del recorrido con checkpoints. Su documentación distingue almacenamiento persistente de memoria RAM, que se pierde al reiniciar. Ese estado ayuda a continuar, pero debe coordinarse con el servicio externo: guardar la conversación no convierte automáticamente una escritura remota en idempotente.
Prueba la respuesta perdida, además del servicio caído
En un entorno aislado, prepara una prueba donde el servidor guarde la incidencia y después se pierda la respuesta. Comprueba que la recuperación deja una sola tarea. Repite el escenario reiniciando el agente y enviando dos peticiones concurrentes con la misma clave.
Comprueba también que un cambio de argumentos no reutilice silenciosamente una operación anterior y que, al agotarse el plazo, la interfaz diga qué se ha confirmado y qué sigue pendiente. Son pruebas propuestas, sin resultados de una implementación concreta. Medir duplicados y recuperaciones reales permite evaluar algo más útil que la frase final del agente.