Ingeniería de IA
ProtoStar lleva los datos científicos abiertos a un reto de predicción climática
El primer reto plantea reutilizar registros de 210 ciudades y comparar predicciones con referencias simples. Qué exige documentar los datos y respetar el corte temporal.
Un reto para comprobar si los datos se pueden reutilizar
ProtoStar propone convertir investigación financiada con fondos públicos en datos, modelos y código que otras personas puedan reutilizar. La iniciativa se anunció el 29 de octubre y su primer reto, Climate Risk Intelligence, está programado del 2 al 13 de noviembre, con Carnegie Mellon como anfitriona. La pregunta resulta más concreta que publicar otro repositorio: ¿puede un equipo ajeno encontrar los recursos, entenderlos y producir un resultado que se pueda evaluar?
Hugging Face aporta infraestructura junto a universidades y organizaciones de ciencia abierta. La publicación de recursos y los retos son parte de la iniciativa; no constituyen por sí solos una demostración de que la IA mejore la investigación. Ese resultado tendrá que salir del trabajo que se pueda reproducir y comparar.
Predecir años posteriores sin conocer sus resultados
El caso climático utiliza registros históricos de 210 ciudades de Estados Unidos. Las bases operativas piden trabajar con información hasta el 31 de diciembre de 2018 y predecir cuatro indicadores anuales de 2019 a 2025: temperatura media, precipitación total, día más caluroso y grados-día de refrigeración. Este último indicador acumula calor por encima de un umbral y se utiliza como aproximación a la demanda de refrigeración.
Hay una diferencia entre páginas que conviene resolver antes de participar: el anuncio inicial incluye 2026 en el horizonte, mientras que la página operativa del reto fija 2019–2025. Esta explicación sigue las bases operativas consultadas. No se han entrenado modelos ni enviado una candidatura para comprobar el proceso de inscripción.
El corte temporal afecta también a las fuentes adicionales. Un dato posterior que dependa del tiempo que realmente hizo puede filtrar la respuesta al sistema. Por ejemplo, usar demanda energética de esos años para predecir su temperatura dejaría de representar una previsión hecha al terminar 2018.
La documentación forma parte del producto
La propuesta tiene una aplicación directa fuera de un concurso. Un archivo accesible todavía puede resultar difícil de usar si faltan unidades, significado de columnas, procedencia o reglas sobre valores ausentes. La guía de preparación de datos públicos de Hugging Face, anterior a ProtoStar, muestra problemas de ese tipo al combinar tablas publicadas con formatos diferentes.
Un ejemplo de trabajo sería preparar una serie de temperatura para otra persona. Además de la tabla, entregaría un diccionario de campos, la unidad, el periodo disponible y el tratamiento de días sin observación. Conservaría la versión de origen y los pasos de transformación. Así un resultado inesperado se puede investigar sin adivinar cómo se construyó la entrada.
La ficha del dataset de CMU separa observaciones diarias, índices anuales e información de ciudades. Sus campos incluyen unidades y datos ausentes. Es información que debe revisarse antes de agregar o mezclar fuentes: convertir un hueco en cero cambia la serie, y combinar temperaturas en escalas distintas puede producir una tabla que carga correctamente pero significa otra cosa.
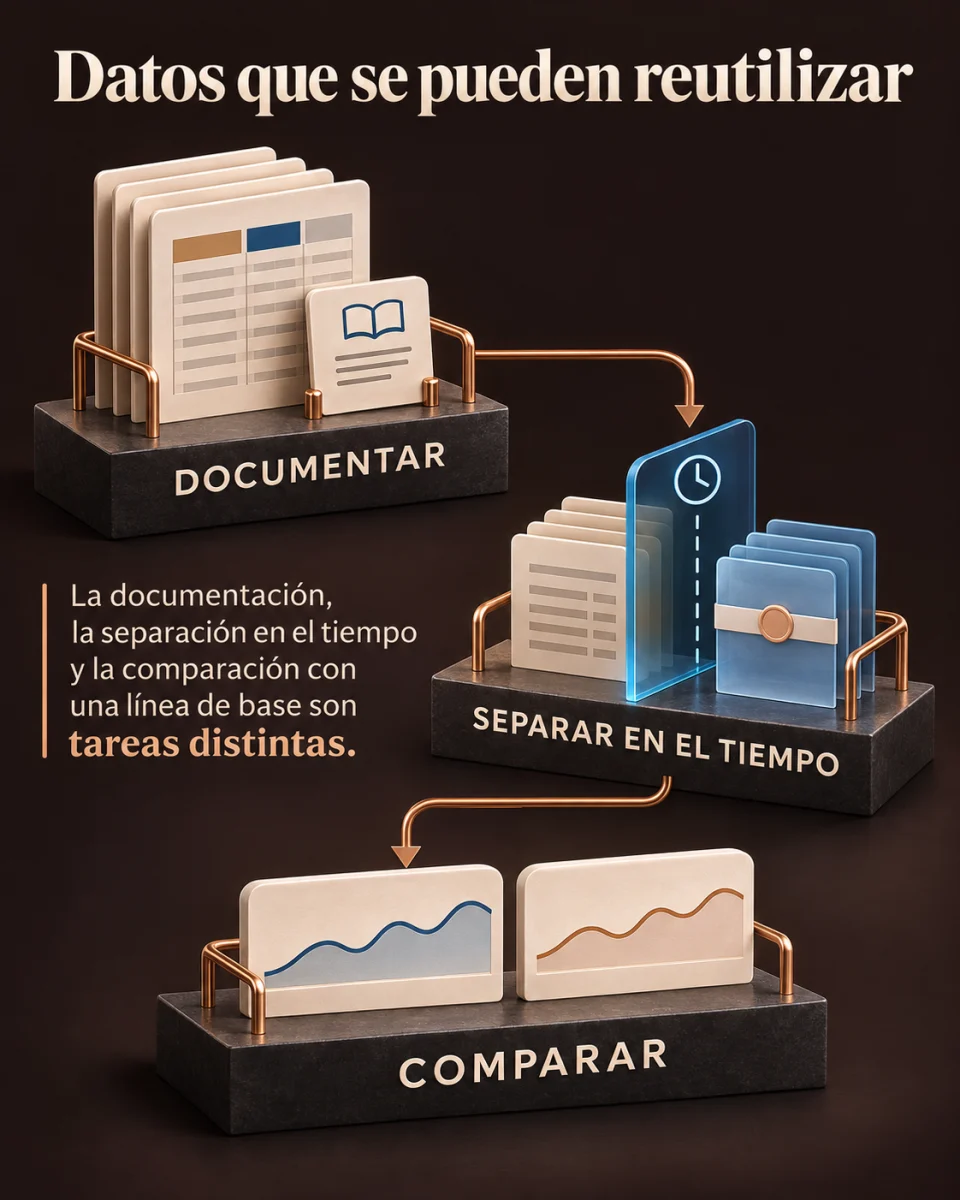
Comparar con una alternativa sencilla
El reto incluye referencias simples: repetir el último año, usar una media de treinta años y prolongar una tendencia lineal. Esa comparación permite preguntar qué aporta la complejidad del modelo. La página separa una puntuación visible de 2019–2021 y una final de 2022–2025, y avisa de que la clasificación pública todavía no está abierta al consultarla.
Para evaluar una propuesta propia empezaría por fijar la separación temporal y reproducir una referencia sencilla. Después compararía los errores por indicador y revisaría dónde empeora. Ajustar una solución repetidamente sobre los mismos años visibles puede dar una impresión de mejora que no se mantenga en el periodo reservado.
El resultado útil también puede ser una barrera bien descrita
Las bases contemplan documentar intentos de reutilización que no funcionan y explicar qué falta para reproducirlos. Eso cambia el entregable: además de una predicción, importa conservar método, código y problemas encontrados. No significa que cualquier fallo tenga el mismo valor; hace falta aislar el obstáculo y aportar evidencia que otra persona pueda revisar.
Empezaría por un recurso pequeño y una pregunta reproducible. Si otra persona puede recuperar la misma entrada, interpretar sus campos y repetir la comparación, ya hay una base para ampliar el trabajo. ProtoStar ofrece un marco público para ensayar ese recorrido; su valor se verá en los resultados y en las barreras que consiga hacer corregibles, no en llamar AI-ready a los archivos.