Actualidad de IA
Meta abre los pesos de Muse Spark Open: qué necesitas para usarlo
Puedes estudiar cómo ejecutar Muse Spark Open por tu cuenta. Sus 42.000 millones de parámetros activos explican solo una parte de lo que necesita para funcionar.
Los pesos están abiertos; el despliegue corre de tu cuenta
Meta publicó Muse Spark Open el 15 de octubre de 2026, con pesos abiertos y orientación a código y tareas con herramientas. Recibe texto, imágenes, audio y vídeo, y responde con texto. Eso permite estudiar un despliegue propio, además de un servicio que lo aloje.
Los pesos son los valores aprendidos durante el entrenamiento. Tenerlos no te da un agente ya preparado con servidor, herramientas y permisos. El acceso en Hugging Face requiere iniciar sesión y revisar las condiciones de Muse Model License, su licencia propia.
42.000 millones activos no cuentan toda la memoria
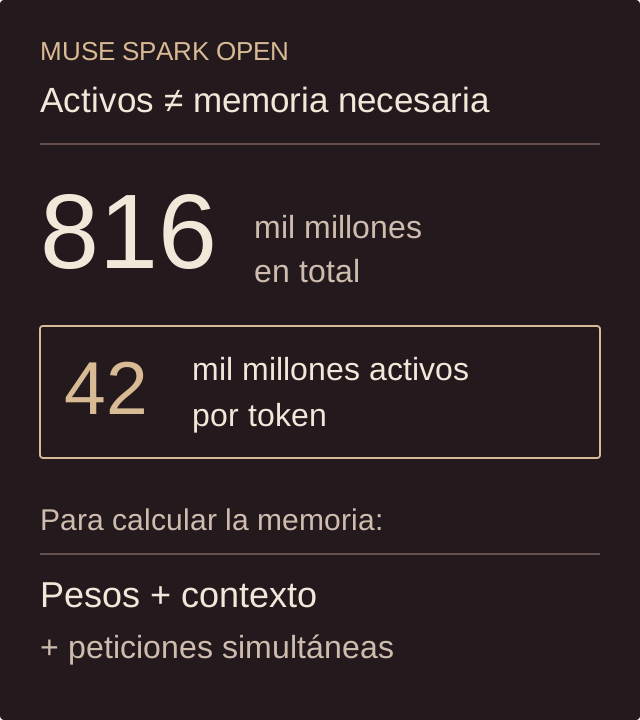
La ficha describe unos 816.000 millones de parámetros totales y 42.000 millones activos por token. Es una mezcla de expertos: en cada paso trabaja una parte de la red. Los demás pesos siguen formando parte del modelo que hay que servir.
Por eso no puedes calcular la memoria como si fuera un modelo completo de 42.000 millones. También cuentan el formato de los pesos, el contexto y cuántas peticiones atiendes a la vez. BF16 y NVFP4 tienen requisitos distintos; cuantizarlo no garantiza que quepa en tu ordenador.
Una captura puede explicar mejor el fallo
Piensa en una aplicación de prueba para reservar salas. Una captura muestra dos reservas iguales y una nota de voz dice que aparecen al pulsar Guardar dos veces. Podrías pedir al modelo que relacione ambas cosas y prepare un cambio con una prueba que detecte el duplicado.
Hay tres resultados que revisar: si entendió la imagen, si interpretó bien el audio y si el código resuelve el problema. Describir bien la captura no demuestra que el parche funcione. Es un ejemplo para diseñar la prueba, no un resultado del modelo.
Lo que entra también depende de la configuración
La integración prepara imágenes, audio y fotogramas de vídeo antes de enviarlos al modelo. Si extraes pocos fotogramas, puedes dejar fuera justo el instante que explica un fallo. Comprueba qué admite el motor que elijas y cómo prepara esas entradas.
La ventana anunciada de hasta un millón de tokens permite recibir mucho contexto. No asegura encontrar cualquier detalle dentro de él. Un documento con dos versiones parecidas de una instrucción sigue siendo una buena prueba de lectura.
Una primera prueba con un objetivo claro
Meta reconoce posibles errores de razonamiento y diferencias entre idiomas y configuraciones. Para una aplicación en español, prueba con su vocabulario y sus formatos. Un repositorio de demostración permite revisar el diff y las pruebas sin dar acceso a un despliegue real.
Después compara la tarea completa: aciertos, correcciones, tiempo y coste operativo. Si lo alojas tú, incluye mantener el servicio. Si lo consumes mediante un proveedor, revisa sus condiciones y tratamiento de datos. La decisión es qué vía resuelve tu necesidad, no solo si puedes descargar los pesos.