Modelos de IA
MiniMax M3.1 Flash pone el foco en el coste de los agentes
MiniMax M3.1 Flash llega por API con precios de 0,15 dólares de entrada y 0,60 de salida por millón de tokens. Un ejemplo para entender la factura y sus límites.
Ya se puede usar por API; los pesos llegarán después
MiniMax lanzó M3.1 Flash el 19 de octubre para tareas con agentes, programación y uso del ordenador. Está disponible en su API, M Plan y MiniMax Code. El anuncio reserva la publicación de los pesos para más adelante, sin dar una fecha. El acceso confirmado en ese lanzamiento es a los servicios alojados.
La propuesta combina capacidad para trabajar con herramientas y una tarifa baja por token, las unidades con las que el modelo procesa y genera contenido. Eso puede importar cuando una tarea necesita muchas consultas, pero el precio de una llamada no dice cuánto costará terminarla bien.
La entrada y la salida tienen precios distintos
La tarifa publicada es de 0,15 dólares por millón de tokens de entrada y 0,60 por millón de salida. La lectura de entrada desde caché figura a 0,015 dólares por millón. Ese último precio corresponde a los tokens que realmente se leen de caché, no a toda la entrada por repetir una consulta.
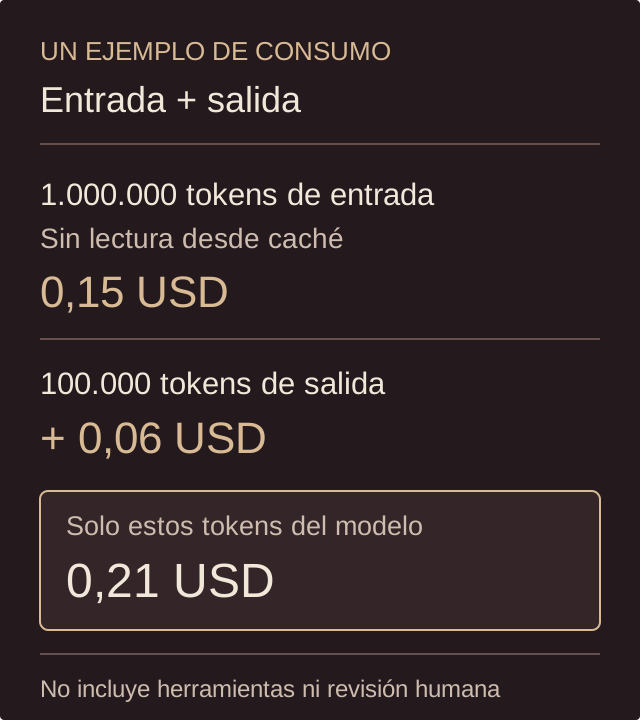
Imagina un lote de tareas que acumula un millón de tokens de entrada sin caché y 100.000 de salida facturada. La parte del modelo sumaría 0,21 dólares: 0,15 por la entrada y 0,06 por la salida. Es un cálculo ilustrativo con las tarifas publicadas, no una prueba de rendimiento ni una estimación de cuántas tareas completaría ese consumo.
Las búsquedas, herramientas, reintentos y revisión humana pueden añadir costes. Para comparar dos modelos usaría el mismo conjunto de tareas y contaría las que llegan a un resultado aceptable, además de los tokens gastados.
También puedes ajustar cuánto razona
La API ofrece hasta un millón de tokens de contexto y permite ajustar el esfuerzo de razonamiento con reasoning_effort. Admite niveles desde low hasta max, que es el valor por defecto. Acepta texto, imágenes, vídeo y contenido de llamadas a herramientas dentro de los mensajes.
Para una tarea sencilla, como clasificar una consulta de soporte, probaría distintos niveles antes de mantener el máximo por costumbre. La comparación útil sería si respeta las categorías y detecta los casos ambiguos, cuánto tarda y qué consumo registra. El nombre Flash no fija por sí solo el tiempo de respuesta de tu aplicación.
Las mejoras anunciadas necesitan una comparación propia
MiniMax anuncia mejoras de velocidad y resultados en pruebas de programación, herramientas y uso del ordenador. Son resultados publicados por el fabricante, no mediciones realizadas aquí. No bastan para trasladar un porcentaje de ahorro a un producto con otros documentos, herramientas o criterios de éxito.
El cambio práctico es que hay otra API con tarifas publicadas para evaluar. Antes de sustituir un modelo que ya funciona, compararía los errores y el coste de corregirlos. Una respuesta barata que obliga a repetir todo el proceso puede salir más cara que la alternativa.