Actualidad de IA
Granite Speech: tres opciones para convertir audio en texto
IBM renueva Granite Speech con transcripción, traducción y etiquetas de hablantes. Así se diferencian Speech 5.0, TurboCTC y 4.1 Plus, también en español.
Elige primero qué necesitas sacar del audio
Pasar una nota de voz a texto, traducirla y distinguir quién interviene en una reunión son trabajos diferentes. IBM presentó el 21 de octubre de 2026 una actualización de Granite Speech con tres opciones para esas tareas. La elección importa más que quedarse con el número de versión más alto.
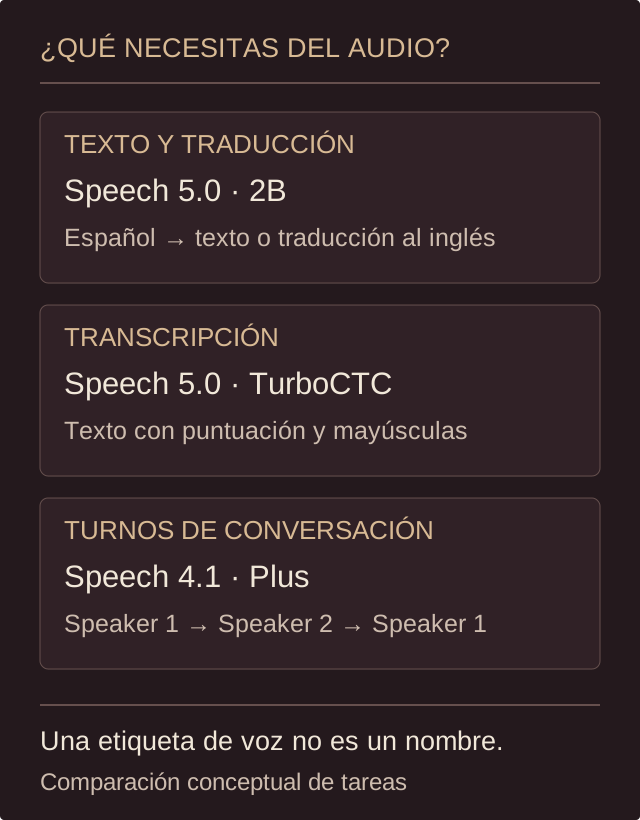
Speech 5.0 2B combina transcripción y traducción. TurboCTC se centra en transcribir con un modelo más pequeño. Para etiquetar los turnos de una conversación, la opción de esta familia sigue siendo Speech 4.1 2B Plus, que también ha recibido una revisión. Los tres tienen pesos publicados y licencia Apache 2.0.
Transcribir y traducir no son lo mismo
Speech 5.0 2B reconoce español, inglés, francés, alemán, portugués y japonés. También permite traducir entre el inglés y esos idiomas. Eso no equivale a admitir cualquier pareja de lenguas: una traducción directa de español a japonés no figura entre las combinaciones documentadas.
Puedes indicar el idioma del audio y aportar términos que deba tener en cuenta, como nombres de productos o siglas. Es una ayuda para reconocer vocabulario, no una garantía de que lo escriba bien. Para grabaciones largas, la ficha recomienda dividir el audio en fragmentos de hasta unos dos minutos antes de procesarlo.
Una opción más ligera cuando solo quieres el texto
TurboCTC tiene 470 millones de parámetros y ahora transcribe siete idiomas, incluido el español. Añade puntuación y mayúsculas directamente. Tiene sentido compararlo si necesitas convertir muchos audios a texto o ejecutarlo cerca del dispositivo que los recoge. Su función aquí es transcribir; no sustituye al modelo de traducción.
IBM publica resultados de velocidad, pero el tiempo que tarde en tu aplicación dependerá del equipo, la duración de las grabaciones y cómo las proceses. Que el modelo sea pequeño no basta para asegurar que vaya fluido en cualquier móvil.
Si importa quién dijo cada cosa
Speech 4.1 Plus admite español y puede añadir etiquetas como Speaker 1 y Speaker 2 antes de cada turno. Los números siguen el orden de aparición de las voces. No te dicen cómo se llama la persona. También tiene un modo de marcas de tiempo por palabra, aunque su salida no incluye puntuación y mayúsculas como la de TurboCTC.
Imagina una reunión ficticia sobre una entrega. Una persona propone el jueves y otra corrige que debe ser el viernes. Una transcripción que conserve las palabras pero cambie las voces puede atribuir mal la propuesta. Antes de generar un resumen, comprobaría esos turnos y la corrección de la fecha escuchando el fragmento original.
La transcripción es una entrada para el siguiente paso
Un agente podría usar ese texto para preparar notas o localizar una petición. Si la transcripción confunde un nombre, una fecha o una voz, el error puede pasar al documento siguiente. Conservar el audio de referencia y revisar los datos que cambian una decisión ayuda a encontrarlo antes.
Para elegir entre estas variantes probaría grabaciones representativas en el idioma que vas a usar, con sus nombres propios y ruido habitual. Miraría los errores que afectan a la tarea y cuánto tarda el proceso completo. La mejor opción para tus notas de voz puede ser distinta de la que necesites para revisar una conversación.