Ingeniería de IA
AQuA de Google: un HTTP 200 puede esconder un agente que falla
AQuA 0.2 revisa conversaciones de agentes ADK y conecta sus fallos con la versión desplegada. Qué aporta, cómo separa entornos y qué sigue necesitando revisión.
El servicio funciona. El trabajo puede estar mal
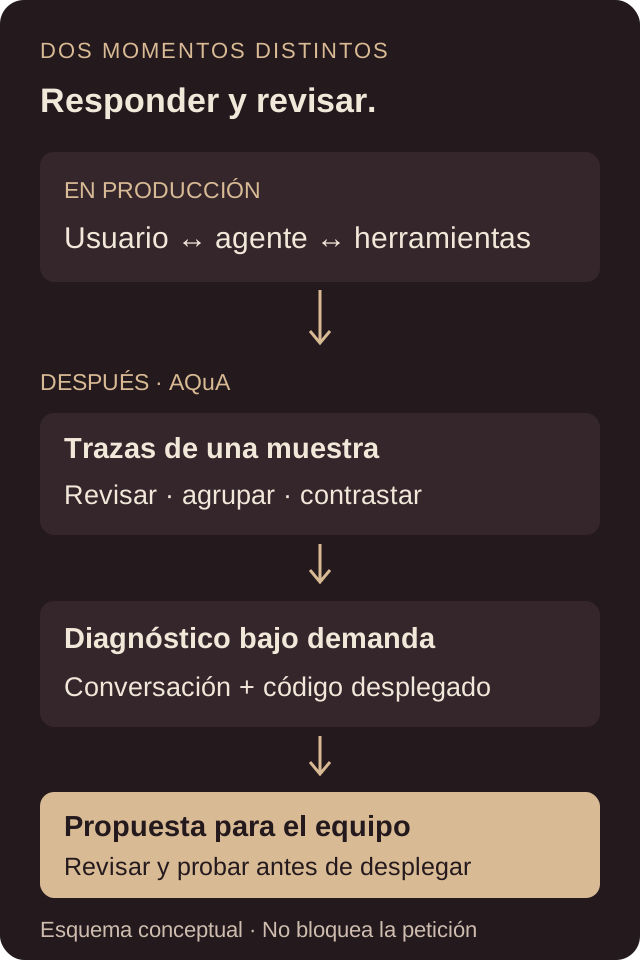
Una petición termina con HTTP 200, las herramientas responden y el agente asegura que ha completado el encargo. Eso acredita que el servicio contestó, pero no que respetara las condiciones del usuario. AQuA, Ambient Quality Agent, busca esos fallos de comportamiento revisando las conversaciones después de ejecutarse.
Google presentó esta implementación de referencia el 8 de octubre. La versión 0.2.0, publicada el 26, permite que una misma instancia observe varios agentes o despliegues ADK. Cada uno conserva su objetivo, configuración, historial y programación. La novedad interesa cuando ya tienes agentes funcionando y necesitas descubrir qué se les escapa en producción.
Revisar fuera del camino de la petición
AQuA lee telemetría de Cloud Trace, Cloud Logging o BigQuery. Revisa una muestra de sesiones, agrupa posibles fallos y contrasta los grupos candidatos con conversaciones completas. Los problemas que superan esa comprobación quedan como hallazgos que pueden reaparecer en futuras revisiones.
El análisis de causa se solicita después y consulta la copia del código que correspondía al despliegue. Puede señalar archivos y líneas o situar el problema en una dependencia o un traspaso entre agentes. Propone cambios, pero no los aplica ni abre una pull request por su cuenta. Esta revisión posterior tampoco bloquea una acción incorrecta mientras está ocurriendo.
La incidencia pertenece a una versión concreta
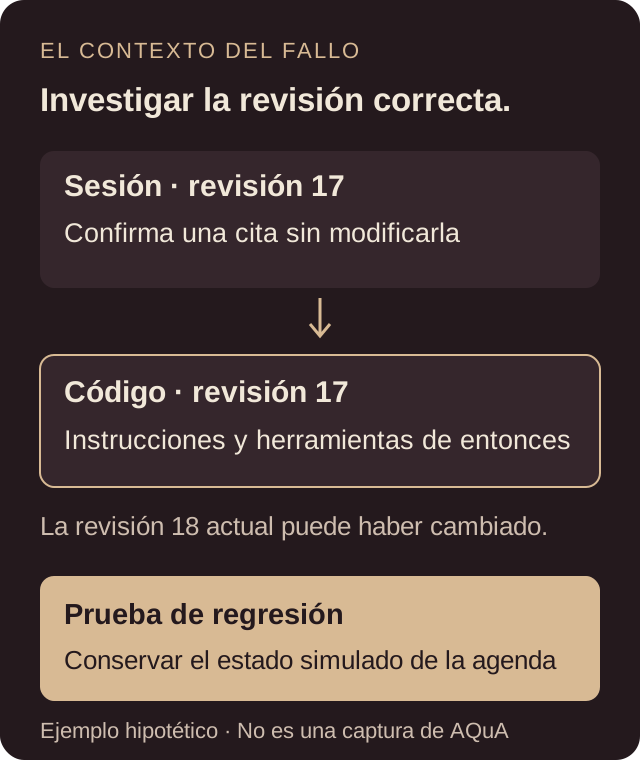
Un ejemplo propuesto: un asistente confirma que ha cambiado una cita, aunque la herramienta solo devolvió las horas disponibles. La llamada terminó correctamente. El error está en afirmar una modificación que no se ha confirmado.
Para investigarlo hacen falta la respuesta del agente, el resultado de la herramienta y las instrucciones vigentes en esa sesión. Si la conversación ocurrió en la revisión 17 y ahora trabajas en la 18, leer únicamente el código actual puede llevarte a corregir una regla que ya cambió. El identificador del despliegue permite unir la evidencia con su contexto.
La prueba de regresión debería conservar también el estado simulado de las herramientas. Reenviar las mismas preguntas contra una agenda que ha cambiado no reproduce necesariamente el fallo. Este ejemplo ilustra el diseño de la revisión, sin atribuirle una detección medida con AQuA.
Una instancia, varios entornos y reglas distintas
La versión 0.2 permite observar, por ejemplo, staging y producción sin mezclar sus objetivos y hallazgos. También agrupa por agente y subagente, para no convertir dos defectos distintos en una sola incidencia. Esta separación de datos y configuración no sustituye el diseño de permisos de acceso.
Hay límites operativos que conviene conocer. La programación se comprueba con un tick de quince minutos, así que una revisión puede empezar con ese retraso. Además, en esta versión agents-cli aqua run usa siempre el agente predeterminado; para investigar otro, las notas indican utilizar el chat del panel, que sigue la selección activa.
Quién puede revisar también importa
La receta está preparada para agentes ADK y su telemetría en Google Cloud. Requiere configurar modelos, almacenamiento y acceso a las conversaciones; no es un monitor universal que se conecte a cualquier agente sin adaptación. Para esta versión necesitas Python 3.11–3.13 y agents-cli 1.10 o posterior, entre otros requisitos.
Las métricas Python personalizadas permiten añadir comprobaciones deterministas al juicio del modelo. Sin embargo, ese código se ejecuta con las credenciales de AQuA. Poder publicar métricas equivale a poder desplegar código en ese proceso. El acceso a esa API necesita más cuidado que un permiso para mirar gráficos.
Un diagnóstico verificable, no una corrección automática
El juez puede equivocarse y la muestra puede omitir un caso raro. Que una revisión no encuentre el fallo no demuestra que haya desaparecido. Para valorar una corrección, conserva casos conocidos y comprueba el comportamiento nuevo frente al anterior.
La aportación útil es reunir conversación, versión y propuesta en una incidencia que se pueda investigar. Encaja si la revisión manual de tus trazas ya resulta insuficiente. Si todavía no registras qué hizo cada herramienta o no has definido qué cuenta como tarea completada, empezar por esos dos puntos dará más claridad que añadir otro agente evaluador.